研究原型 · 已完成公开数据复核
药研 AI 模型
谁预测得更准
把模型预测和实验结果放在一起,比较谁更准,差异出在哪些化合物上。
背景 / 模型用在哪里
候选分子很多
实验资源有限
新药研发需要研究候选分子对细胞的影响。但实验时间、样本和经费有限,研究者尝试用细胞图像、分子结构等信息预测实验读数,为后续验证提供参考。
本工具的公开案例聚焦一个具体任务:预测给药后的细胞代谢活性,再与实验实测值核对。它不评价药物在人身上是否有效或安全。
为什么做 / 模型升级之后,还差一次核对
加了更多数据
真的预测得更准吗
比如,旧模型只用细胞图像,新模型再加入分子结构。团队需要知道:整体误差有没有下降?哪些化合物改善了,哪些反而变差?比较前,还要核对记录有没有重复、统计口径是否一致。
- 上游 / 已有结果
模型预测 + 实验实测
两组模型的已有预测,以及同一批实验的实测值。
- 本工具 / 结果复核
查数据、比误差、找差异
核对记录,比较整体表现,再追到具体化合物与实验孔。
- 下游 / 人来判断
决定下一轮研发重点
继续改模型、排查数据或补充验证;不是自动选择药物。
为什么重要 / 把分数变成可复核的结果
决定下一步怎么做
不能只看一个总分
总体误差更低,也可能在部分化合物上预测得更差。团队需要看到这些差异,再决定还要做哪些验证。
Excel 和 Notebook 也能算误差。这里把数据检查、整体比较、逐化合物复核放进同一流程,方便算法与实验同事对照同一批结果讨论。
本页已有真实案例选定的融合模型整体误差更高,但部分化合物更准。查看结果与限制 ↗目标是让模型评审更容易复核。当前只支持 OASIS 封存预测的离线复核,团队试用尚未开展,节时与研发收益尚未验证。
看32秒操作短片 ↓- 01 / 放在一起
已有预测
对照实验结果同一组实验结果,两组模型已有的预测。
- 02 / 看整体
先比平均误差
预测离实验结果有多远?MAE 越低越准。
- 03 / 看个例
再看每个化合物
整体落后,也可能在某些化合物上更准。
- 04 / 查输入
重复记录先停下
比较前先检查数据;发现重复就暂停。
合成数据交互演示
自己比一次
先看哪组预测更准
再找出结果不同的化合物
核对数据关联与唯一性
3 个化合物 / 9 行 / 9 个唯一孔化合物与实验孔关联 已对齐
合成观测值与两组预测 无缺失
实验孔唯一性 9 / 9
检查通过:9 个唯一孔,可进行模型比较。
加入一个重复孔,查看错误提示。
比较同一评估集上的预测误差
MAE · 越低越好仅评估 9 个合成实验孔,预测结果固定,不执行模型训练。
平均绝对误差 MAE:预测与观测之间的平均偏差,越低越准。这里按 9 个孔等权计算。
基线模型误差更低
0.042222MAE · 平均偏差融合模型
0.067778MAE · 平均偏差| 预测模型 | 孔数 | MAE | 计算口径 |
|---|---|---|---|
| 基线模型 | 9 | 0.042222 | 同一组合成数据 |
| 融合模型 | 9 | 0.067778 | 同一组合成数据 |
本组合成数据中,基线模型的整体 MAE 较低,部分化合物的结果不同。
化合物 A · 3 个合成实验孔
基线模型 MAE 0.030000 / 融合模型 MAE 0.083333
基线模型误差更低
0.030000MAE · 平均偏差融合模型
0.083333MAE · 平均偏差横向滚动查看全部列 →
| 合成实验孔 | 合成观测值 | 基线模型 | 绝对误差 | 融合模型 | 绝对误差 |
|---|---|---|---|---|---|
| A-1 | 0.22 | 0.25 | 0.03 | 0.32 | 0.10 |
| A-2 | 0.36 | 0.34 | 0.02 | 0.42 | 0.06 |
| A-3 | 0.51 | 0.55 | 0.04 | 0.60 | 0.09 |
化合物 A:基线模型误差较低。
其余合成化合物的数据
每行依次为合成观测值、基线预测与融合预测。
B-1:0.58 / 0.61 / 0.59;B-2:0.67 / 0.63 / 0.68;B-3:0.78 / 0.74 / 0.80。
C-1:0.80 / 0.86 / 0.92;C-2:0.92 / 0.87 / 1.04;C-3:1.04 / 0.97 / 1.12。
JSON 包含合成数据、质控结果与误差明细。计算仅在浏览器内完成,不上传或保存研究数据。
三步复核流程
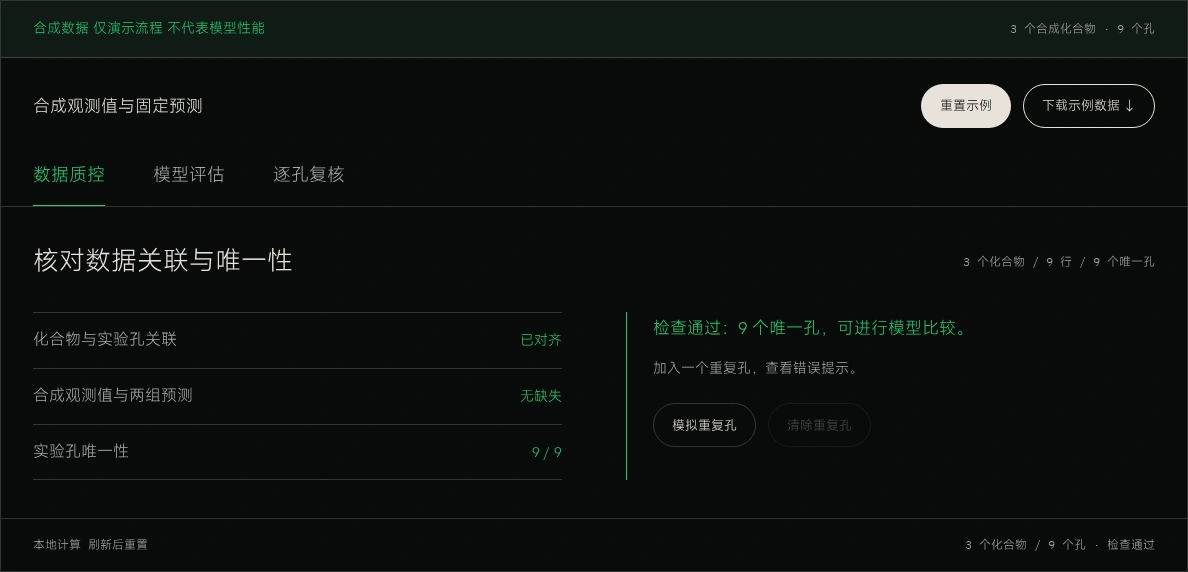
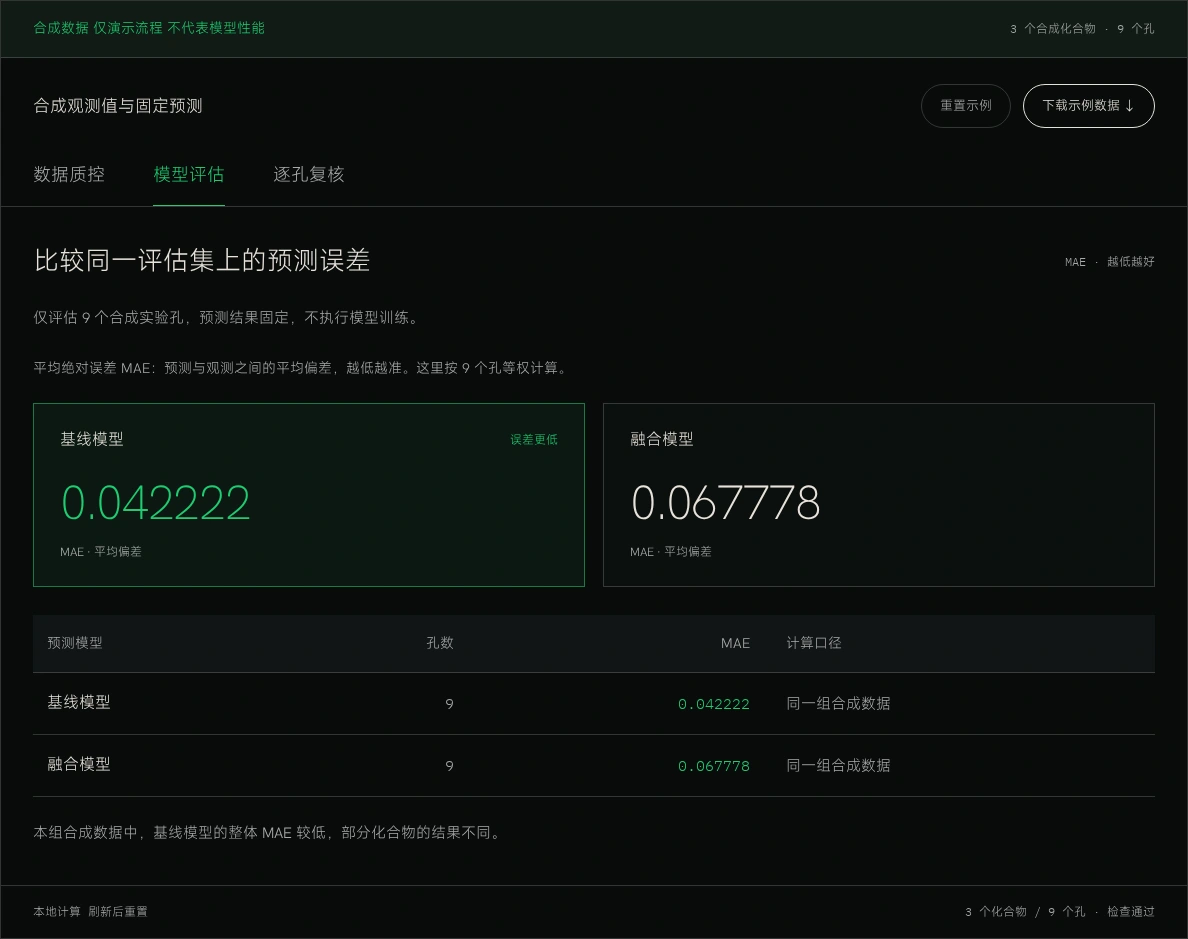
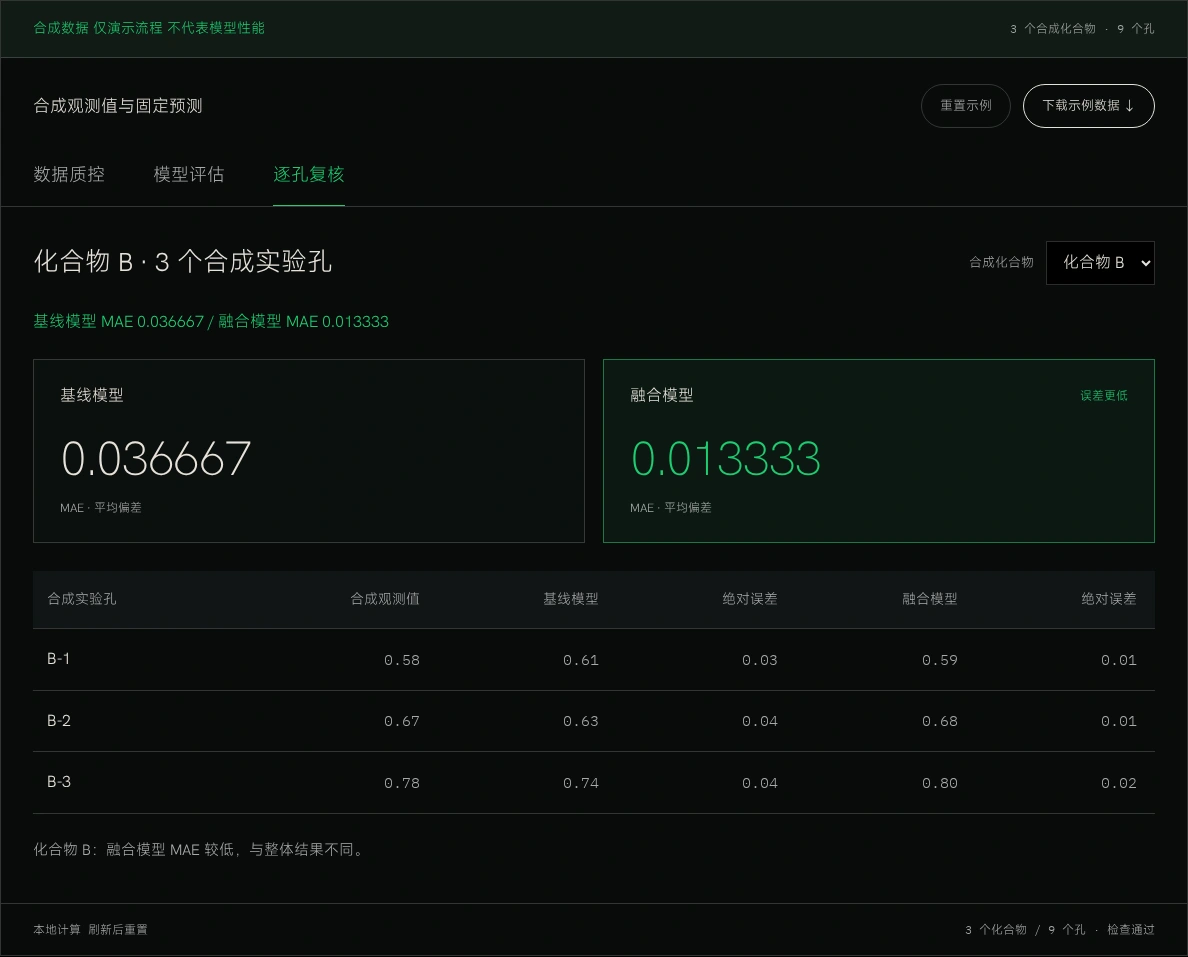
以上为合成数据演示界面,不对应真实实验结果。
已完成 / 历史预测复核
本轮融合模型MAE 高于基线
以下为已完成的离线研究评估,与上方合成数据演示无关。
评估队列:934 个化合物、14,175 个孔,比较 10 个模型。
历史测试子集128 个化合物 · 1,928 个孔
平均绝对误差 MAE 越低越好
融合模型 MAE 高 6.72%50 个化合物误差更低 · 78 个更高
实验终点44 h、相对 DMSO 的 RealTime-Glo MT 代谢活性,不是人体或临床毒性。
评估局限历史测试集此前已被查看,不构成独立盲测。两组模型的算法不同,误差差异不能单独归因于特征融合。
完整数值与计算方式
CP-HGB:0.06764545242315631
原选融合 MLP(seed 43):0.07219277411308278
融合 MAE − 对照 MAE:0.00454732168992647
化合物按母体结构合并。先在同一化合物内平均孔绝对误差,再对化合物等权平均。以上误差仅对应 128 个母体化合物、1,928 个孔的测试子集,不是全队列独立测试。合成示例则按孔等权。
这是对历史预测的新复核,不是新训练或新独立测试。934 个化合物为过滤后队列。仅展示已核验汇总,非原始报告截图;不提供真实明细或报告下载,也不由上方合成数据产生。这次比较不能推出“融合无用”。作者公开数据记录 ↗
研发进度与适用范围
当前支持 OASIS 封存预测的离线评估,不支持任意数据表导入。真实研究报告仅限本地使用。
- 已有
- 已完成离线评估流程、公开数据复核与合成数据交互演示。
- 待验证
- 独立验证与研发团队试用。
尚未接入原始图像、病理切片或 RNA 数据,不提供在线推理与模型训练。商业化价值、药研效益与临床获益尚未验证。
软件验收记录
G0–G3 软件验收通过;1,160 项 CPU 测试通过,11 项 CUDA 测试跳过,本轮未做 GPU 验证。这些是软件测试,不代表科学获益或临床验证。本工具不提供诊断或临床决策。